11月13日上午,第一届数据科学与智能决策前沿论坛在浙江大学紫金港校区求是大讲堂举行。本次论坛是浙江大学建校130周年系列活动"科技与人文大讲堂"之一。
当前,数据科学、因果推断与智能决策加速交叉融合,为智能决策提供了新的理论和方法工具。论坛旨在汇聚相关领域专家学者,交流最新进展,推动数据科学与智能决策协同发展。围绕数据科学理论、因果推断、高维统计、结构化模型与图模型、机器学习预测及其在智能决策中的应用等前沿议题,论坛安排了一场主旨报告和四场学术报告。

论坛开幕式由浙江大学求是讲席教授郭子剑主持,浙江大学求是讲席教授、数据科学研究中心主任孙文光致欢迎辞。

郭子剑主持

孙文光致辞
为感谢德国国家科学院院士、苏黎世联邦理工学院Peter Bühlmann教授长期以来对浙江大学统计学和数据科学等领域发展的关心和支持,对双方国际学术合作、人才培养和学科交流作出的积极贡献,孙文光教授代表学校为Peter Bühlmann教授颁发致谢铭牌。

孙文光为Peter Bühlmann颁发铭牌
开幕式后,Peter Bühlmann教授围绕“Extrapolation”作主旨报告。报告聚焦人工智能预测中普遍存在的外推问题,从函数外推与组合结构外推两个方面展开:针对中高维协变量场景下测试点常落在训练数据覆盖区域之外的挑战,报告提出了Xtrapolation概念框架,使任意机器学习算法都能实现外推感知的推断;针对训练数据仅含单一活跃协变量、测试输入涉及多个活跃协变量的组合外推场景,报告提出了DExtrI方法,将交互效应外推至训练数据支撑范围之外。

Peter Bühlmann 报告
复旦大学朱雪宁副教授以“Consistent Selection of the Number of Groups in Panel Models via Cross-Validation”为题作邀请报告。针对面板数据建模中的分组数量选择这一关键问题,报告提出了一种交叉验证方法:在保留个体分组结构的前提下,沿时间维度将面板数据划分为两个数据折并设置缓冲区,先在一个数据折上估计分组隶属关系与参数,再在另一数据折上评估设计准则,通过最小化所有数据折的平均准则来估计分组数量。该方法完全数据驱动、无需额外的模型特定调节参数,可灵活应用于广泛的面板数据模型,并已被用于分析2008年金融危机期间中国股市波动率的异质性模式。

朱雪宁报告
上海交通大学刘林副教授以“Robust covariate adjustment in randomized clinical trials at any dimensions”为题进行报告。在现代随机临床试验中,FDA指南倡导调整预后协变量以提高处理效应估计的效率。报告介绍了一系列适用于任意协变量维度的稳健协变量调整方法:证明了高阶影响函数是在线性工作模型下统一现有各类调整方法的正确框架;提出了首个支持二值或计数结局、可稳健调整任意数量协变量的JASA与JASA-cal方法;并将方法进一步拓展到广义机器学习调整、协变量自适应随机化以及生存结局场景。相关方法已集成为R软件包HOIFCar,独立基准测试显示其性能优于现行FDA指南推荐的方法。
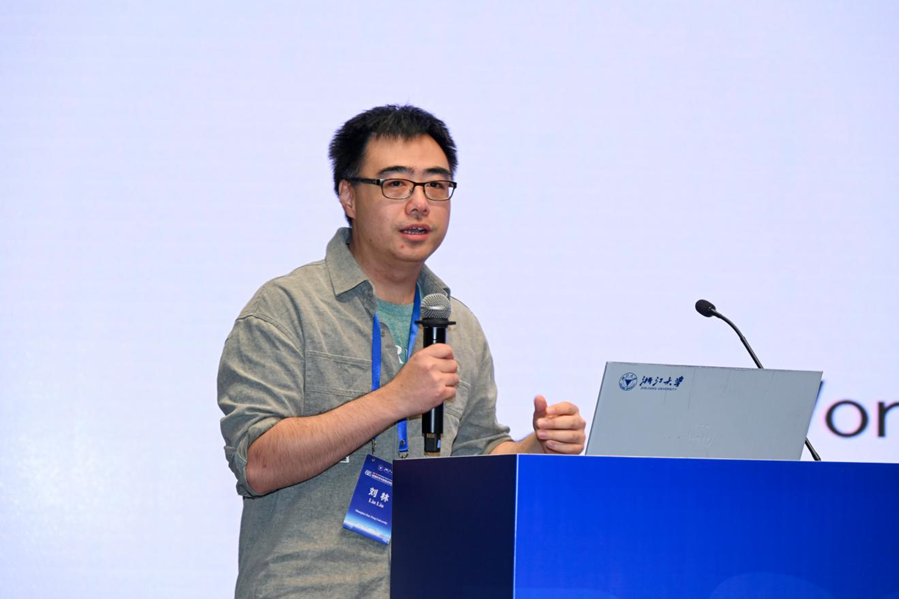
刘林报告
南京大学叶翰嘉副教授报告的主题为“Foundation Models for Structured Data: From Prediction to Discovery and Beyond”。面向结构化数据尤其是表格数据的基础模型,旨在无需任务特定训练即可跨任务、跨数据集实现泛化预测,但表格数据异构的语义与多样的结构给模型构建带来重大挑战。报告系统介绍了相关研究进展:一是提升表格基础模型的预测性能与推理效率;二是将表格基础模型从预测拓展至因果发现,实现因果关系识别与因果图生成;三是探索超越显式表格数据、支持多样嵌入空间上通用预测建模的路径,及其在多模态学习、控制与强化学习、模型路由等方面的潜在应用。

叶翰嘉报告
浙江大学况琨副教授以“Causal Tabular Foundation Models for Causal Discovery, Stable Prediction, and Identifiable DAG Learning”为题进行分享。基于先验数据拟合网络(PFN)的表格基础模型虽能通过大规模合成数据预训练实现强零样本预测,但其本质仍是黑盒后验估计器,捕获潜在因果机制的能力不明,且在分布偏移、伪相关与异质因果机制下泛化能力不足。针对这一差距,报告提出了三个因果表格基础模型:DCD-PFN实现显式结构因果发现,通过样本级解耦权重识别马尔可夫边界并以并行化的局部到全局解耦发现重建全局CPDAG;StablePFN采用"解耦—发现—预测"架构,通过马尔可夫边界注意力掩码强制预测仅依赖因果特征,实现跨环境稳定预测;DAG-FM通过将识别问题分解为递归的叶节点与父节点预测、并利用叶子专家混合(Mixture-of-Leaf-Experts)在机制特定专家间路由,实现异质机制下可扩展、可识别的DAG学习。

况琨报告
五场报告分别由郭子剑教授以及宋昊天、夏新涛、顾嘉、崔政研究员主持。参会师生与报告人围绕报告内容进行了深入交流与讨论。

本届论坛聚焦数据科学与智能决策领域的前沿进展,为相关领域学者提供了高水平的学术交流平台,将进一步推动数据科学与智能决策的协同发展,助力智能决策理论与方法的创新。